A comprehensive guide to optimizing LLM inference by eliminating padding overhead with hardware-aware sequence packing.
The post I Built a C++ Backend So My GPU Would Stop Eating Air appeared first on Towards Data Science.
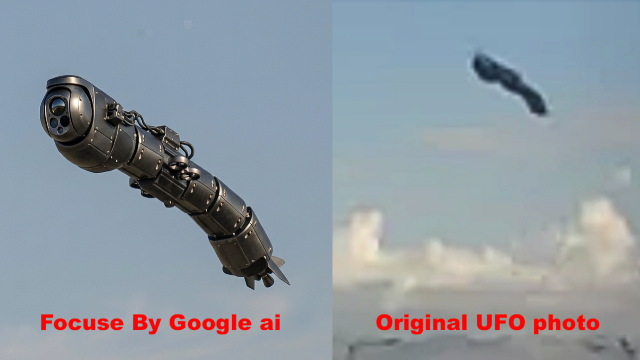
Date of sighting: Oct 12, 2026Location of sighting: Rhodes International Airport, GreeceSource: https://www.skylinewebcams.com/en/webcam/ellada.htmlDirect cam: https://www.skylinewebcams.com/en/webcam/ellada/naigaio/dodecanisa/rhodes-international-airport.htmlIf you check quickly the link above...it might still be on…
Read More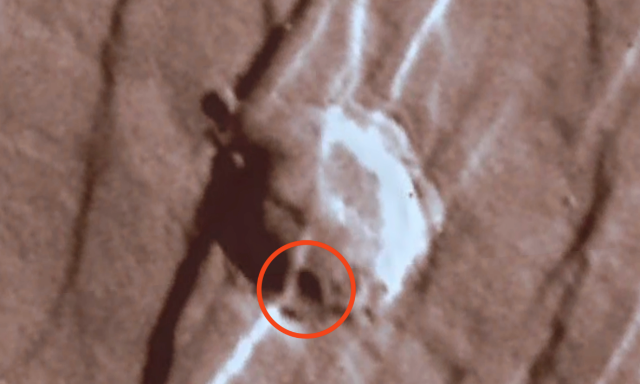
Date of discovery: Oct 11, 2026Location of discovery: MarsSource map: https://explore-mars.esri.com/While using a new Mars map, I came across a huge 3 mile by 1…
Read MoreA comprehensive guide to optimizing LLM inference by eliminating padding overhead with hardware-aware sequence packing.
The post I Built a C++ Backend So My GPU Would Stop Eating Air appeared first on Towards Data Science.